Meta의 새 비즈니스 약관, 웹사이트 AI 크롤링 논란 촉발
Meta의 개정된 상업 약관이 AI 개발을 위해 자사 도구를 사용하는 기업의 웹사이트를 광범위하게 크롤링할 수 있는 권한을 부여하며, 표준화된 거부(옵트아웃) 방식이 없다는 보도가 나왔다.
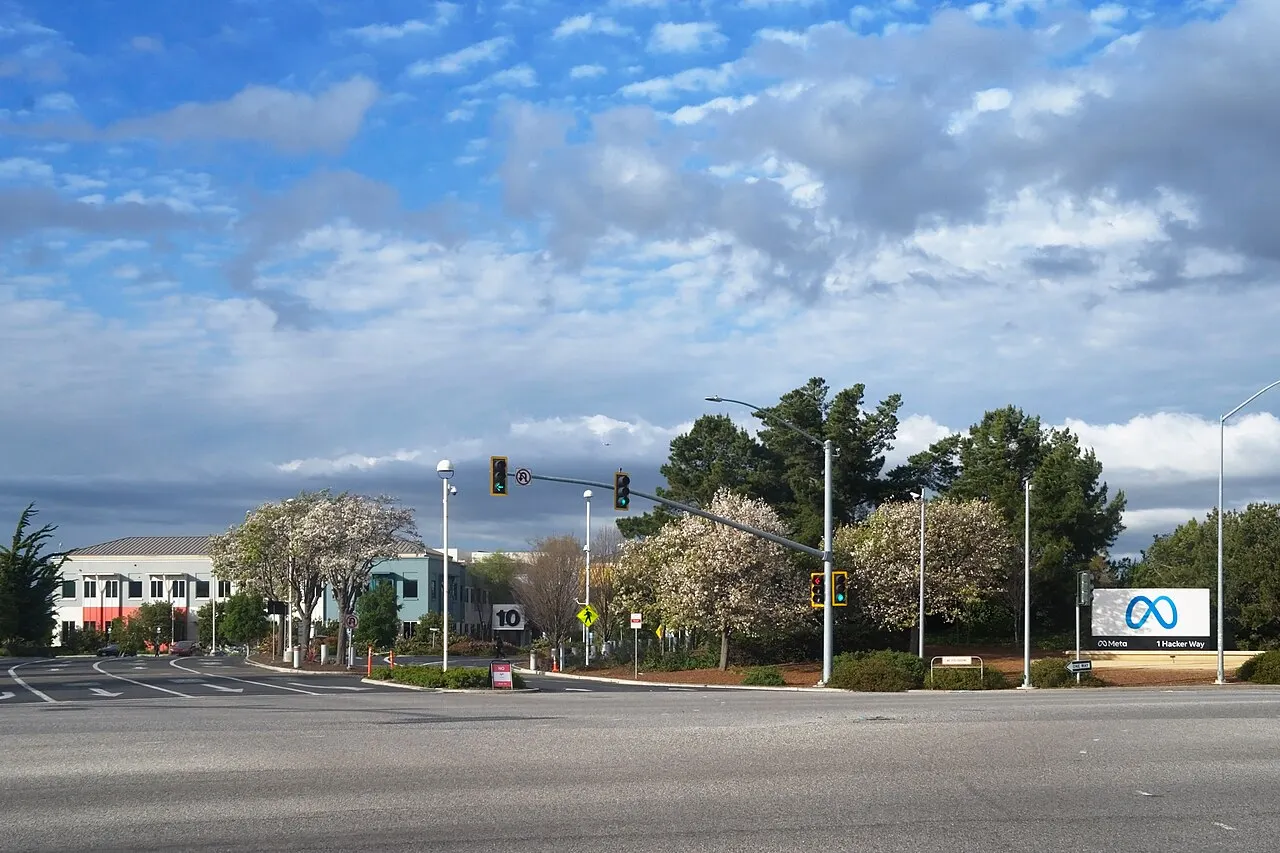
페이스북, 인스타그램, 왓츠앱의 비즈니스 도구에 적용되는 개정 상업 약관을 두고 2026년 10월 중순 언론사와 기업들의 비판이 이어지고 있다. 제기된 주장에 따르면, 새 조건은 Meta가 AI 시스템을 개발하기 위해 해당 비즈니스 계정과 연결된 도메인을 자동으로 크롤링할 수 있는 넓은 재량을 부여한다.
핵심 쟁점은 약관에 표준화된 옵트아웃 방식이 빠져 있다는 점이다. 이로 인해 기업은 Meta의 상업 생태계에 남을지, 아니면 자사 웹 콘텐츠를 스캔당하도록 허용할지 사이에서 선택해야 할 수 있다. 소셜 트래픽에 크게 의존하는 독립 언론사에게 이 시장을 떠나는 것은 곧 일부 독자층과의 접점을 잃는 것을 의미한다.
페이월과 테스트 자격 증명
비평가들은 Meta가 테스트 자격 증명을 생성할 수 있도록 하는 조항에 대해서도 의문을 제기하고 있으며, 이것이 언론사가 구독 수익을 보호하기 위해 사용하는 페이월과 멤버십 시스템에 어떤 의미를 가질지 묻고 있다. 해당 조항이 실제로 어떻게 작동할지, 계약상 허용 범위가 어디까지인지는 지금까지 제기된 주장만으로는 판단할 수 없다.
Meta는 사이트 운영자가 robots.txt 파일을 통해 자동화된 크롤러를 차단할 수 있다고 밝힌 것으로 전해졌다. 그러나 이 파일은 봇에게 지침을 제공할 뿐 접근 통제 수단이 아니며, 준수 여부는 크롤러를 운영하는 쪽에 달려 있다.
법적·경제적 쟁점
코넬 로스쿨의 제임스 그림멜만 교수는 이 분쟁의 법적 측면을 짚었다. 콘텐츠 소유자는 자신의 자료가 사용되는 조건을 정하고 싶어 하지만, 플랫폼의 상업 서비스 이용이 고정된 계약 조건 수용에 달려 있다면 협상력은 줄어든다. 특정 접근을 허용하는 계약이 저작권, 사이트 이용 약관, 관련 법률을 자동으로 무효화하지는 않으며, 이는 별도로 검토되어야 한다.
이번 논란은 Meta가 외부 링크를 통해 수익을 창출하려는 움직임과 맞물려 있어, 플랫폼과 언론사 간 힘의 균형에 대한 질문을 더욱 부각시키고 있다. 다만 크롤링된 콘텐츠가 얼마나 사용될지, 그리고 그것이 Meta의 모델에 어떻게 반영될지에 대한 구체적인 기술적 세부 사항은 아직 나오지 않았다.
댓글
아직 댓글이 없습니다. 토론을 시작하거나 질문해 보세요.
관련 기사
해고된 백악관 대변인 케이티 재커리는 AI 탐사 사업으로 전환 중인 광산 기업 NRED에서 발표된 자문직이 가짜였다고 말했다.

Anthropic이 2026년 10월 16일 공개한 보고서에 따르면, 회사 내부에서 Claude를 적극 활용하면서 신입 기술직 채용 비중이 줄었고 회의 시간은 20% 늘었다.

비판이 거세지자 메타는 2026년 10월 17일, 뉴스 사이트를 포함한 웹 콘텐츠를 AI 학습용으로 스크래핑하는 것을 허용하는 것으로 전문가들이 해석한 문구를 상업용 약관에서 삭제했다.