Nvidia、120Bパラメータのオープンウェイト型エージェントモデル「Nemotron 3.5 Super VL」を発表
Nvidiaは2026年10月15日、企業向けAIエージェントを想定した1200億パラメータのオープンウェイトモデル「Nemotron 3.5 Super VL」を、新たなエッジ向けモデル2種とともに公開した。
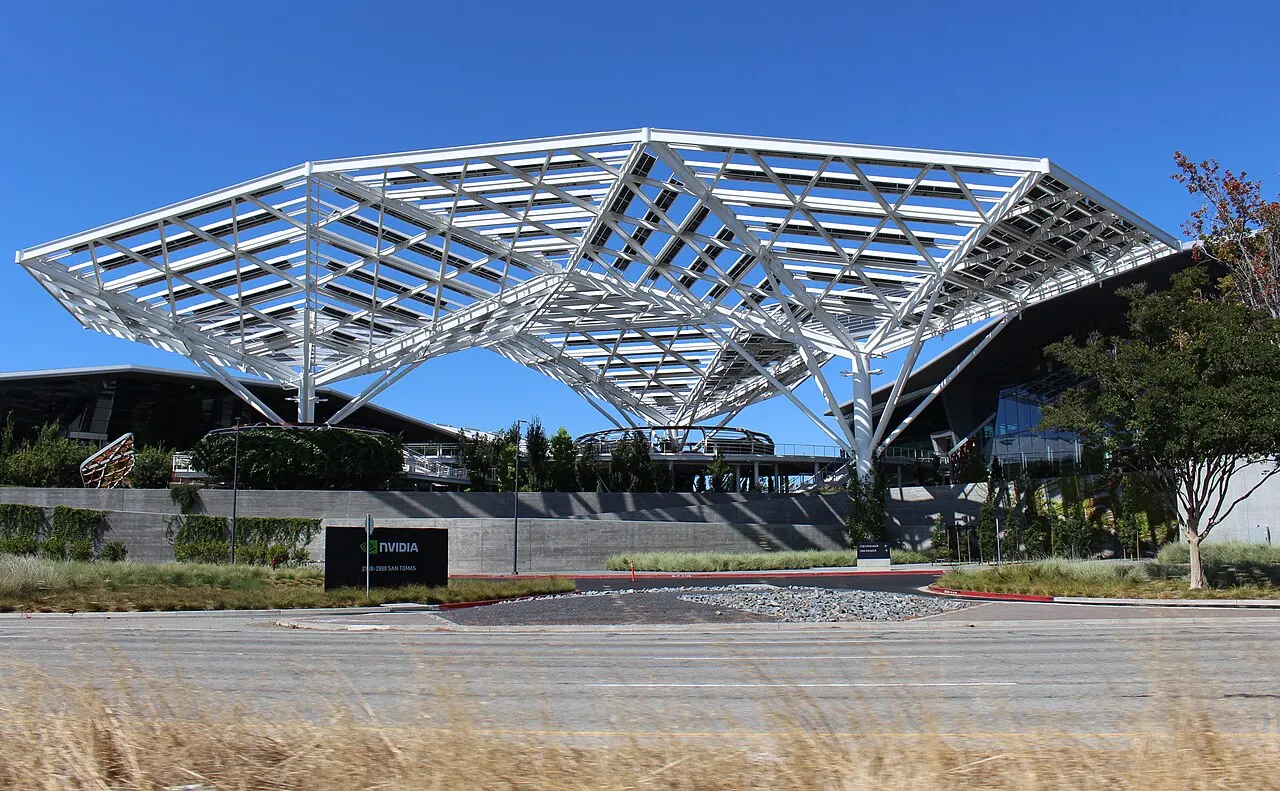
Nvidiaは2026年10月15日、1200億パラメータを持つ新しいオープンウェイトAIモデル「Nemotron 3.5 Super VL」の提供を開始した。同社はこのモデルを、継続的に稼働する専門特化型エージェント向けと位置づけており、そうした用途で最も速くタスクを完了し、最も高い精度を実現すると主張している。
Nvidiaは、Super VLを同サイズクラスで最速のオープンなエージェント型モデルと説明し、最も近い競合の5倍の速度で動作すると述べている。この数値は、Artificial Analysisが同程度のサイズのモデルと比較して行ったベンチマーク結果によるものだ。InclusionAIの「Ling 3.0 Flash」が2位、DeepSeekの「V4.1 Flash」が3位に入ったが、いずれもSuper VLには大きく差をつけられた。
ポストトレーニングによる性能向上
同社はまた、企業が特定分野向けにポストトレーニングを施すことで、ベースモデルがどれほど改善しうるかも強調した。Nvidiaが挙げた一例では、ポストトレーニングによって医療保険の請求処理タスクで44%の向上が得られ、その分野においてClaude Opus 5を大きく上回った。これは、ベースモデルが出荷時の状態で独自の最先端システムを上回るわけではないものの、カスタマイズすれば的を絞った改善をもたらせることを示している。
Nvidiaは、オープンモデルの本質的な魅力は、企業が自社データで学習させ、自社のインフラ上でホスティングできる点にあると主張している。これにより、パーソナライゼーションやセキュリティをより高度に管理できるという。「大量のタスクをより速く完了するのに役立つ」とNvidiaはSuper VLについて語った。
Nvidiaによると、これと同時に2種類のエッジモデルも登場する。「Nemotron 3.5 Bolt 74B-A9B 24GB」と「Nemotron 3.5 Bolt E4B 4GB」だ。前者はネットワーク接続なしでローカル動作するよう設計され、デバイス上でのエージェント利用を想定している。後者は高速な対話型エージェント向けとされる。
変わりゆくオープンモデルの勢力図
DeepSeekやMoonshot.aiといった中国の研究機関は、近年、競争力のあるオープンウェイトモデルの分野をリードしてきた。しかし、欧米の開発者も巻き返しを図っている。フランスのMistralは最近「Le Chonk」を公開し、一部のベンチマークで最先端の数値を記録した。また、Nvidiaが支援しており、買収に向けた協議中と報じられているReflection AIは、その前週に「Beam」モデルを発表した。
OpenAIと関係のあるHugging Faceへの侵害事件以降、オープンモデルへの関心も高まっている。この事件は、オープンなシステムだけがセキュリティリスクを抱えるという考えを揺るがした。米国で開発されたオープンモデルが中国製の代替モデルと十分に渡り合えれば、サイバーセキュリティ上の指針で外国製技術が敬遠される分野でも、影響力を広げられる可能性がある。Super VLが実world利用で意味のある水準の向上をもたらすかどうかは、今後の検証を待つ必要がある。
コメント
まだコメントはありません。議論を始めるか、質問してください。
関連
Metaは2026年10月15日、8160億パラメータのオープンウェイトモデル「Muse Spark Open」を公開した。Apple M5 Ultra搭載のMac Studio 2台で動作できるという。
中国のKunlun Techが、ゲームエンジンとリアルタイムAI映像レンダリングを組み合わせたオープンソースシステム「Matrix-Game 4.0」を発表した。一般消費者向けGPU1基で動作するという。
SpaceXAIの新しい音声対音声モデル「Grok Voice 3.0」が、Artificial Analysisの音声対音声指標(Speech-to-Speech Index)で86.9のスコアを獲得し、首位に立ちました。