Meta-Geschäftsbedingungen erlauben KI-Crawlern, verlinkte Websites zu durchsuchen
Neue Bedingungen für Meta Business Suite, die am 30. Oktober 2026 in Kraft treten, ermächtigen Meta, verknüpfte Websites, darunter auch Nachrichtenverlage, zu durchsuchen und die Inhalte zum Training von KI zu nutzen.
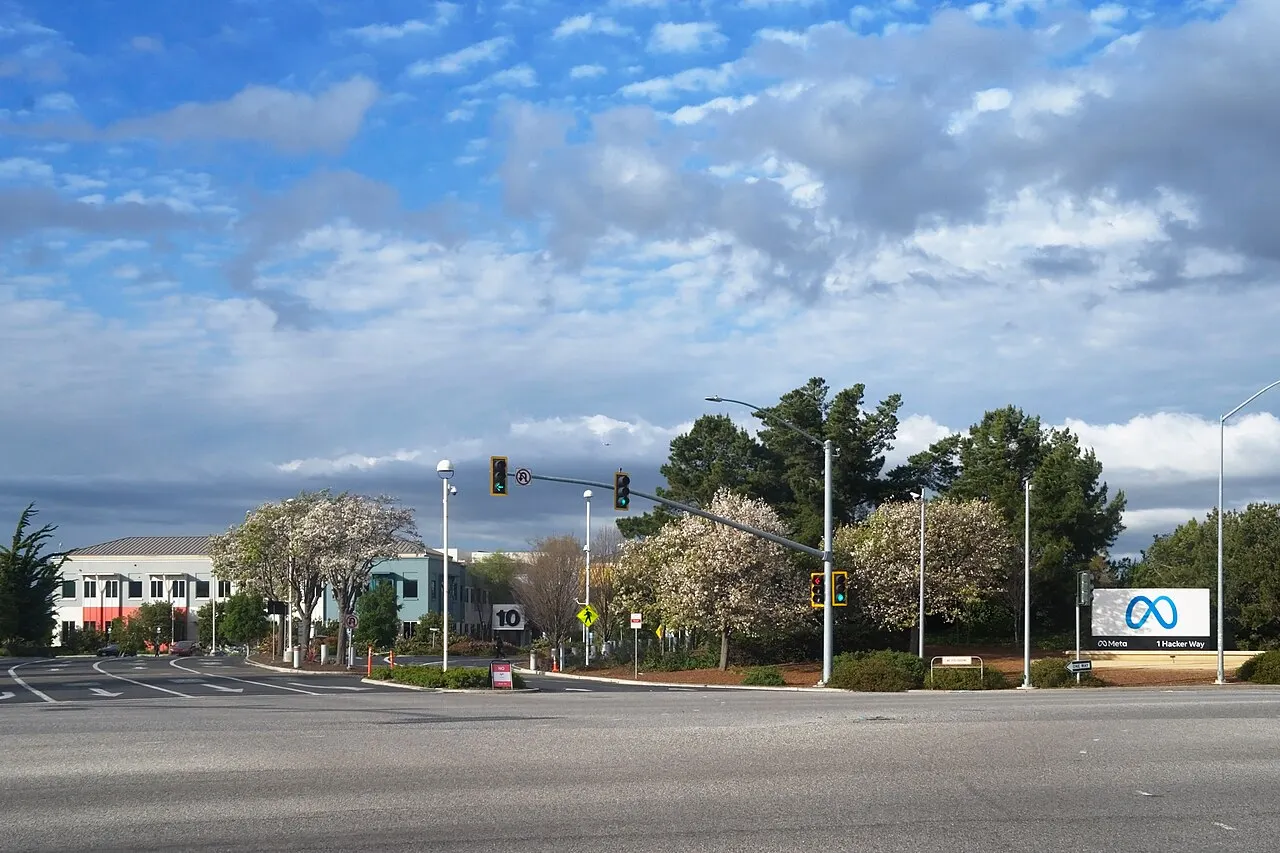
Meta hat seine kommerziellen Bedingungen so überarbeitet, dass Websites, die mit Meta-Business-Suite-Konten verknüpft sind, von den automatisierten Werkzeugen des Unternehmens durchsucht werden können, so Rechtsexperten. Nachrichtenverlage fallen in diesen Geltungsbereich. Die überarbeiteten Bedingungen treten am 30. Oktober 2026 in Kraft, und Meta bietet keine Widerspruchsmöglichkeit an.
Meta Business Suite ist das Dashboard, mit dem Unternehmen ihre Instagram-Profile, Facebook-Seiten sowie ihre Messenger- und WhatsApp-Kanäle verwalten. Konten, die die neuen Bedingungen nicht akzeptieren, verlieren den Zugang zur Plattform. Verlage müssen daher entweder dem Scraping zustimmen oder die Plattform aufgeben.
Was die Bedingungen erlauben
Nach dem neuen Wortlaut ermächtigen Kontoinhaber Meta oder in deren Auftrag handelnde Dritte, Scraper, Bots, Spider, Crawler und User Agents gegen Domains einzusetzen, die mit ihren Produkten oder Dienstleistungen verknüpft sind. Meta darf die Inhalte indexieren, zwischenspeichern, analysieren und sammeln, Testzugangsdaten erstellen und in regelmäßigen Abständen Aktualisierungen abrufen. In den Bedingungen heißt es, das Material könne genutzt werden, um Metas Produkte und Funktionen zu entwickeln, zu erforschen und zu trainieren.
Meta weist die Vorstellung zurück, dass etwas Neues aufgezwungen werde. Das Unternehmen beschreibt die Aktualisierung als Zusammenführung seiner kommerziellen Bedingungen und der Bedingungen für Self-Service-Werbung, die damit in einem Dokument gebündelt werden und im Kern bereits bestanden hätten.
Ein größerer Streit um Nachrichteninhalte
Nieman Lab vermutet, dass die Formulierung es Meta erlauben könnte, Lizenzvereinbarungen mit zahlreichen Verlagen zu umgehen. Das Training von KI-Modellen erfordert enorme Datenmengen, und Journalismus ist begehrt, weil er in der Regel redigiert und faktengeprüft ist, anders als ein Großteil der Texte, die aus dem offenen Web gesammelt werden.
Verlage argumentieren, dass KI-Suchfunktionen ihre Reichweite und damit auch ihre Werbeeinnahmen geschmälert haben. Mehrere Verlage, darunter Ziff Davis, haben KI-Unternehmen verklagt, weil diese ihre Werke für das Modelltraining nutzen und Anfragen beantworten, ohne die Quellen zu nennen. Einige KI-Labore haben stattdessen Lizenzvereinbarungen mit Nachrichtenorganisationen geschlossen, um solche Streitigkeiten zu vermeiden.
Der Ansatz von Meta fällt auf, weil die Einwilligung in eine Dienstleistungsvereinbarung eingebettet ist, auf die viele Medienhäuser angewiesen sind, um ihre Leserschaft zu erreichen. Für Verlage, die auf Facebook und Instagram zur Verbreitung ihrer Inhalte setzen, hat eine Ablehnung der Bedingungen einen realen Preis.
Kommentare
Noch keine Kommentare. Starten Sie die Diskussion oder stellen Sie eine Frage.
Ähnliche Meldungen
Replit-CEO Amjad Masad sagte, die KI-Coding-Plattform habe die Zusammenarbeit mit Anthropic wegen Kosten und Leistung eingestellt. Eine vertraute Person erklärt jedoch, die Partnerschaft bestehe weiterhin.
Die KI-Forschungseinheit Seed von ByteDance hat ein Team für Alignment & Preparedness aufgebaut und sucht weltweit zehn Forscher für die Besetzung.
OpenAI behauptet, ein ehemaliger Mitarbeiter, der zu Apple gewechselt ist, habe mehr als 100 Dateien zu einem unveröffentlichten Produkt auf ein privates Konto weitergeleitet und später Apple-Führungskräften präsentiert.